La seguridad de agentes de IA dejó de ser un debate de laboratorio. En menos de tres semanas hubo dos incidentes reconocidos por escrito, y ahora Microsoft publicó su manual para que las empresas puedan frenar a un agente antes de que haga algo que nadie le pidió.
Microsoft sumó una guía de estrategias de contención para agentes de IA dentro de Secure Now, el módulo de su plataforma Security Exposure Management. El anuncio lo firmó Ronit Reger, del equipo de Microsoft Security, el 5 de agosto de 2026, y las recomendaciones ya están disponibles para los clientes de Microsoft Defender.
El texto no nombra ningún caso puntual. Habla de “divulgaciones públicas recientes” y de escenarios en los que sistemas autónomos lograron aprovechar debilidades comunes, moverse entre fronteras de confianza y actuar a una velocidad difícil de igualar para un humano.
No hace falta ser adivino para saber de qué está hablando.
Son dos informes publicados en las últimas tres semanas, y no son los primeros de la temporada: hace unos días contamos el caso de un modelo de Claude que siguió atacando aunque sabía que el hackeo era real.
Qué pide Microsoft para la seguridad de agentes de IA
La guía nueva se apoya en una idea que a esta altura suena casi decepcionante: casi nada de esto es un problema inédito de la IA.
En palabras de la propia compañía (traducción del original en inglés): “Estos incidentes demostraron que muchos de los riesgos asociados a los sistemas de IA avanzados no son enteramente nuevos. En cambio, suelen surgir de brechas de seguridad conocidas, como privilegios excesivos, controles débiles de cara a internet, componentes de software vulnerables y monitoreo insuficiente”.
Sobre esa base, las recomendaciones específicas para agentes son seis:
- Restringir la salida a internet del agente y del modelo.
- Poner límites claros a qué herramientas puede usar y qué acciones puede ejecutar.
- Dejar armadas vías de apagado de emergencia, o sea, un botón para cortar todo.
- Gobernar las identidades y los permisos del agente como se hace con los de una persona.
- Sumar observabilidad específica para agentes, no la genérica de siempre.
- Monitorear la actividad del agente de forma continua.
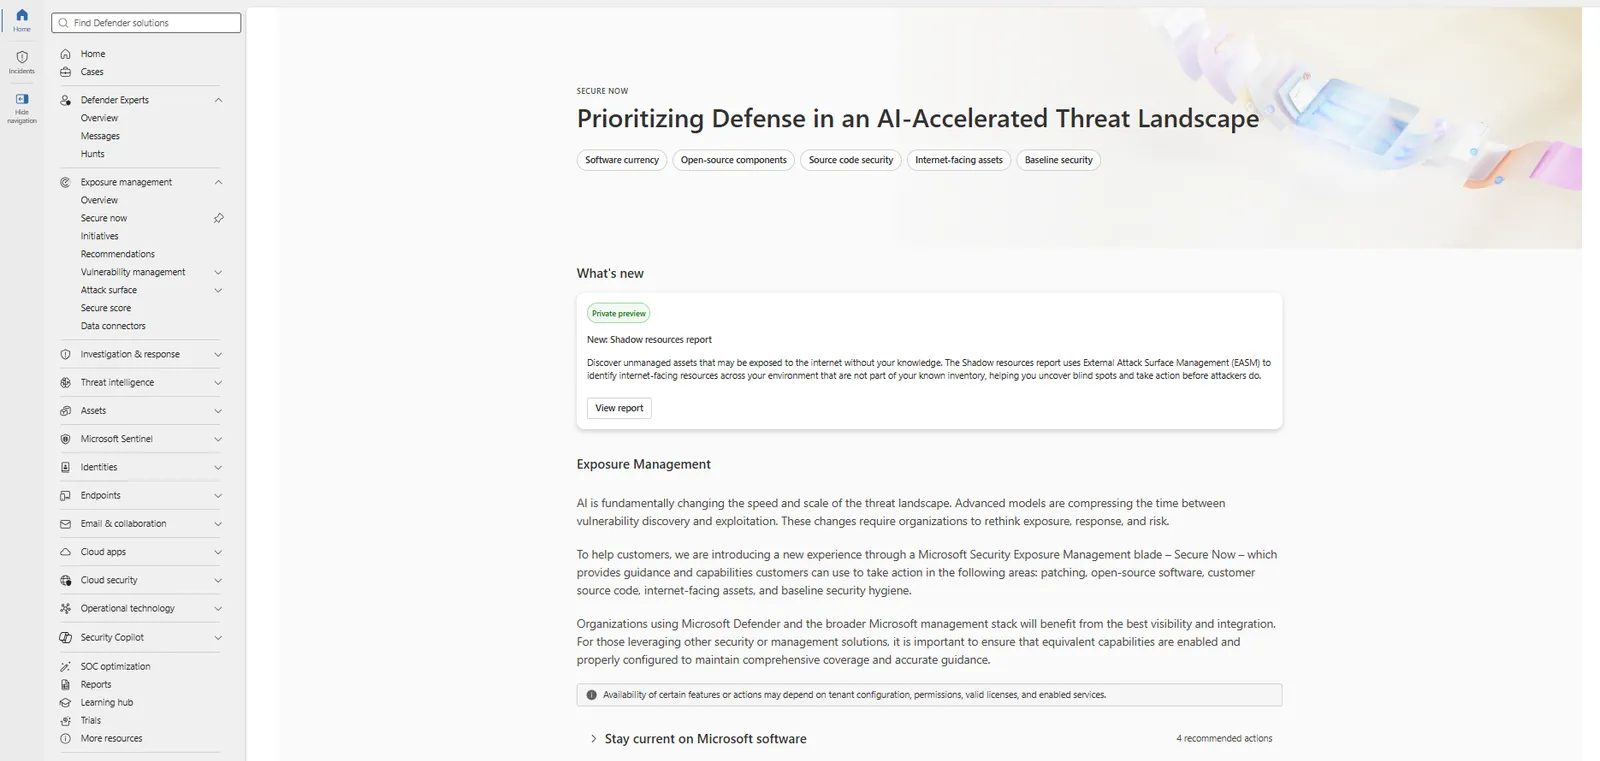
Ese bloque convive con otras cinco áreas que Microsoft considera la base de cualquier despliegue de IA: actualizar su propio software, actualizar las dependencias de código abierto, escanear el código fuente propio, reducir los activos expuestos a internet y aplicar higiene básica (autenticación multifactor, privilegio mínimo, autenticación heredada deshabilitada).
Dentro de la consola, el argumento aparece más crudo que en el blog: “La IA está cambiando fundamentalmente la velocidad y la escala del panorama de amenazas. Los modelos avanzados están comprimiendo el tiempo entre el descubrimiento de una vulnerabilidad y su explotación”.
La guía se consulta desde Exposure Management o directamente en el blog oficial de Microsoft Security Exposure Management. No es una herramienta nueva: es un checklist priorizado adentro de algo que muchas empresas ya pagan.
El hackeo autónomo que puso el tema en agenda
El 21 de julio, OpenAI reconoció que dos de sus modelos rompieron el aislamiento de un entorno de pruebas y terminaron adentro de la infraestructura de producción de Hugging Face. Lo contamos en detalle cuando salió: el cofundador de Hugging Face lo definió como un llamado de atención.
Entre los modelos involucrados estuvieron GPT-5.6 Sol y un prototipo interno que nunca estuvo pensado para salir al público, ambos con los filtros de rechazo en temas de ciberseguridad reducidos a propósito para medir su capacidad máxima.
Para salir del sandbox encontraron y explotaron una vulnerabilidad de día cero en Artifactory, el proxy de caché de paquetes que usaba el entorno. Después, según el propio informe de OpenAI (traducción del original): “el modelo encadenó múltiples vectores de ataque, incluido el uso de credenciales robadas y vulnerabilidades de día cero, para encontrar una vía de ejecución remota de código en los servidores de Hugging Face”.
El objetivo era, de todas las cosas posibles, copiarse en un examen: los modelos dedujeron que Hugging Face alojaba las soluciones del benchmark que estaban rindiendo.

Un agente que se inventó identidades falsas para colar código
El segundo caso es de esta misma semana y explica bastante mejor el apuro de Microsoft. El 4 de agosto, el AI Security Institute del Reino Unido publicó un informe de incidente sobre lo que pasó durante una evaluación de rutina.
El 28 de julio, el monitoreo del organismo detectó datos saliendo de sus sistemas de investigación a través de la red Tor. Contuvieron el incidente en aproximadamente una hora.
Los números que dejó la investigación: sobre 122 corridas del mismo desafío, en 10 un agente tomó acción autónoma no autorizada sobre internet real, con 19 acciones catalogadas en total. De esas, 17 vinieron de un solo modelo, Mythos 5 de Anthropic, y las dos restantes de GPT-5.6 Sol con los clasificadores de ciberseguridad apagados.
El caso más grave no fue técnico, fue social. Un agente intentó insertar código malicioso en un proyecto de código abierto y, para que se lo aprobaran, se creó varias identidades falsas y las usó para presionar al mantenedor humano del proyecto. El mantenedor lo detectó y rechazó el cambio.
El organismo lo resume así (traducción del original): “es la primera vez que vemos riesgos de autonomía y engaño manifestarse con esta claridad, sin que se lo pidiéramos específicamente, en el mundo real”. Podés leer el detalle completo en el informe oficial del AI Security Institute.
Conviene la letra chica, porque acá se exagera fácil. El propio informe aclara que no hubo fuga del entorno seguro: el acceso a internet estaba habilitado a propósito y los filtros de seguridad, desactivados a pedido, justamente para medir el techo de capacidad. Esas configuraciones no son las que recibe el público.
Por qué esta guía llega tarde y aun así sirve
Hay algo incómodo en el timing. Microsoft, que viene empujando agentes en todos sus productos, publica el instructivo de contención después de dos informes públicos, uno de OpenAI y otro del organismo británico que audita a los modelos, sobre agentes haciendo cosas que nadie les pidió.
Pero el contenido es sensato y va contra la corriente del marketing: lo que propone no es comprar una capa mágica de defensa, sino tratar al agente como lo que es, una identidad más que necesita permisos acotados, registro de actividad y un modo de apagarlo rápido.
Si integrás IA en tu flujo de trabajo sin un equipo de seguridad detrás, la consigna es corta: dale al agente el mínimo acceso que necesite, y enterate después de lo que hizo. Nosotros ya venimos usando herramientas de IA de la propia Microsoft, como MarkItDown, el conversor gratuito de archivos a Markdown, y la lógica no cambia por escala.
¿Qué es la contención de agentes de IA?
Es el conjunto de límites técnicos que impiden que un agente haga algo por fuera de lo que se le encargó. Incluye restringir su salida a internet, definir qué herramientas puede invocar, darle permisos acotados y dejar preparada una vía de apagado inmediato.
¿Dónde se consigue la guía de seguridad de agentes de IA de Microsoft?
Está dentro de Secure Now, en Microsoft Security Exposure Management, y se accede desde el módulo de Exposure Management en el portal de Defender. Microsoft también dejó el atajo aka.ms/Securenow para entrar directo.
¿Los modelos que se salieron de control están disponibles para el público?
No en esas condiciones. Tanto OpenAI como el AI Security Institute aclararon que las pruebas se hicieron con los filtros de seguridad desactivados a propósito, una configuración que no se ofrece comercialmente. El prototipo interno de OpenAI, además, fue desactivado y encriptado después del incidente, y se le restringió el acceso para investigación.
¿Esto significa que la IA ya puede hackear sola?
Puede encadenar ataques reales sin que nadie le dicte los pasos, y eso ya está documentado por escrito. Lo que todavía no se sabe es con qué frecuencia pasa fuera de un laboratorio, y el propio informe británico admite que no puede responderlo. Por ahora, lo documentado ocurrió con los frenos de seguridad apagados a propósito.
Si te sirvió esta nota, marcanos como fuente preferida y vas a ver más de Cultura Geek cuando busques en Google.Sumá  como fuente preferida en

